主要技术:Gin、GORM、Redis、Asynq、WeKnora
项目目录
项目简介
WeKnora 是一套以 Go 为后端的知识管理与智能问答平台。它汇集团队文档,用于资料问答、Agent 任务和 Wiki 整理;知识库支持文本与图片处理,回答可以关联资料出处,方便继续阅读原文。
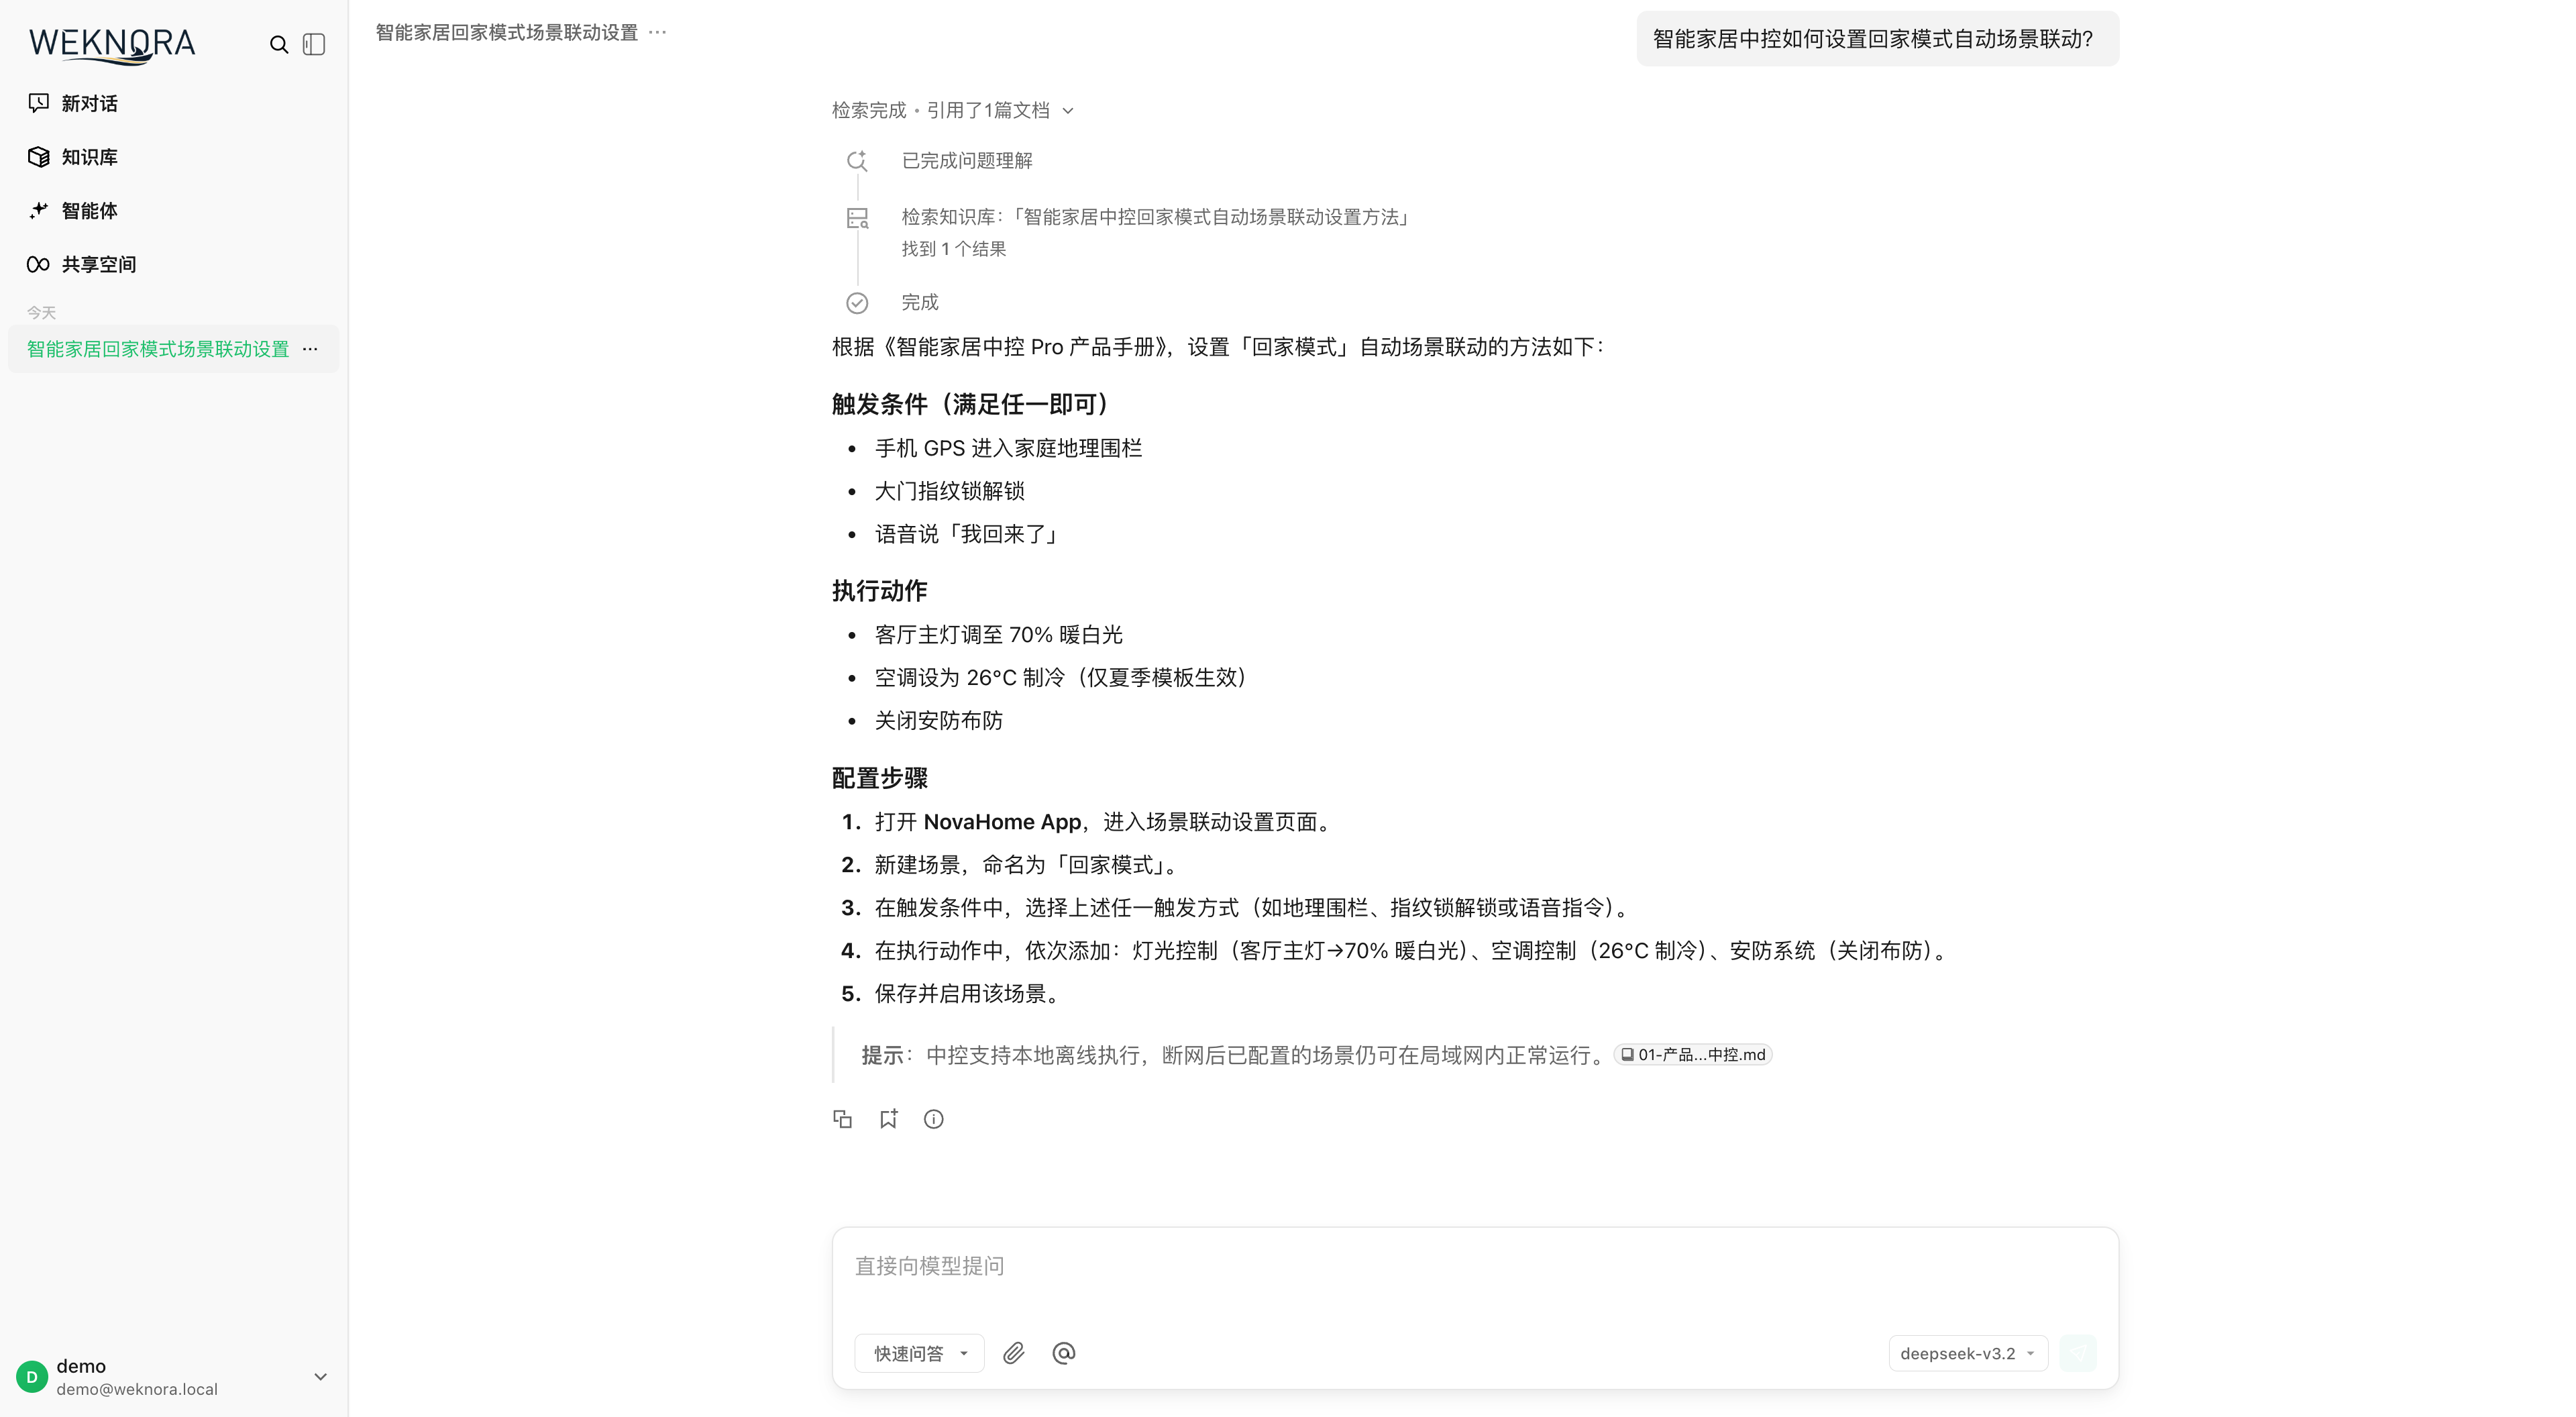
在项目提供的界面示例中,用户询问智能家居中控怎样设置“回家模式”,系统检索产品手册,整理触发条件、执行动作与配置步骤,并提供文档引用。用户也可以管理上传资料、查看解析结果,再围绕同一份知识库继续提问。
项目亮点
- 图片也能进入知识检索: 按处理策略将图片描述或
OCR文字写为子块,保留原图信息、来源位置与ParentChunkID,让图中文字和图意参与检索。 - 小块匹配与父正文补全: 启用父子分块后,小块承担匹配,聊天合并阶段沿关系补充父段及关联正文,同时保留原始命中内容,避免只取到脱离条件的局部说明。
- 混合候选与可选重排: 向量和关键词列表通过加权
RRF融合;重排阶段模型不可用或调用失败时,可以保留已有检索候选继续处理。 - 分阶段异步入库: 采用
Redis/Asynq的部署将文档、图片和后处理任务分开调度,以重试、状态及子任务计数推进处理;上传完成不直接等于整份资料可用。
技术架构
文件先进入存储与知识记录,后台任务调用文档解析器,再处理分块、图片与索引。Go 服务负责业务编排,解析能力按文件和部署配置选择;向量、关键词检索及模型供应商均通过对应接口接入。
问答时,聊天管线组织检索、可选重排与上下文合并,沿父子关系补正文,为引用保留实际片段的身份与来源,再交给模型生成。前端提供知识库、对话与资料回查界面。后台任务也支持不依赖 Redis 的进程内 Lite 执行器。
| 代码位置 | 主要职责 |
|---|---|
internal/handler/、internal/application/service/knowledge_create.go |
接收文件,保存知识记录并创建后台任务 |
internal/application/service/knowledge_process.go、internal/application/service/image_multimodal.go |
解析、父子分块、图片文字和描述处理 |
internal/application/service/knowledgebase_search.go |
检索候选、融合、重排及来源数据组装 |
internal/application/service/chat_pipeline/ |
补齐问答上下文,处理生成与引用 |
internal/router/task.go、frontend/ |
注册任务处理器,展示知识库与对话界面 |
如何写进简历
点检随手查 · 生产线点检图文助手 | 制造业场景示例
项目描述:面向生产线点检人员的图文知识助手,检索操作规程与接线图,将图像识别内容和正文共同用于问答,返回带原图及文档出处的点检参考。
技术栈:Go、Gin、GORM、Redis、Asynq、WeKnora
主要工作:
- Redis 与 Asynq 分阶段入库:基于
Redis与Asynq将手册解析、图片处理和索引写入拆为异步任务,结合超时、有限重试及子任务计数推进状态;区分上传、处理中与可检索阶段,衔接点检资料的长耗时入库。 - 图像子块与正文来源关联:按图片处理策略生成
OCR或图像描述子块,通过ParentChunkID关联操作正文,并保留SourceLocators与原图信息;将识别出的端子文字、图示说明和相邻步骤纳入检索资料,支持图文联合问答。 - 父子上下文合并与图像保留:在聊天链路沿图片、文本与父正文关系批量补取上下文,按实际命中的文本范围收敛图片信息;合并重叠片段时保留图像识别正文,减少只返回孤立编号或引入其他页面图示的问题。
- 扩展上下文与原始引用分离:将模型使用的扩展正文与原始命中片段分别组织,按片段身份回取正文和图片子块,保留各自文档与图像来源;让点检回答能回查具体资料,减少整段父正文被错误归为局部图像证据。
课件随问 · 课程图文答疑助手 | 教育业场景示例
项目描述:面向课程学习者的图文答疑系统,从讲义、课件与图解中检索概念和例题,补充相关定义、条件及图示说明,帮助学习者理解答案并回查资料。
技术栈:Go、Gin、GORM、WeKnora、Redis
主要工作:
- 父子分块与课程上下文补全:以小片段参与概念与例题检索,在聊天合并阶段批量读取父正文,并处理重复与相邻内容;保留定义、条件和图示说明的关联,改善短问法命中局部文字后上下文不足的问题。
- 加权 RRF 与混合检索排序:以向量检索覆盖自然问法、关键词检索保留课程术语,通过加权
RRF融合候选并归一化得分;对多路重复命中统一排序,为概念解释与图文例题选择相关资料。 - 重排失败回退与链路连续性:在已取得候选的基础上接入重排模型,模型加载或调用失败时保留检索结果继续后续问答;区分重排失效、资料为空与正常排序,避免可选精排异常直接中断课程答疑。
- 图文引用与原片段身份恢复:在父正文扩展后单独恢复原始片段与图片子块的引用身份,将讲义解释、图解识别内容和文档来源分开关联;回答展示可回查的资料依据,避免把扩展内容统一标成某个局部图解。
面试题与回答
3 题Asynq 如何组织异步任务执行、重试与故障恢复,与通用消息队列有何区别?
展开收起
核心回答
在采用
Redis/Asynq的部署中,WeKnora将文档上传与耗时的解析、切分、索引分开执行,再通过图片处理和后处理任务推进文档状态。任务队列负责调度与重试,数据库中的文档记录负责展示业务进度;上传成功、Worker 返回成功、文档最终可用是不同层面的结论。文件上传后任务怎样执行?
上传服务先保存文件和
pending文档记录,再把租户、知识库、文档与文件路径放入DocumentProcessPayload。Worker 的ServeMux将文档任务交给ProcessDocument,图片任务和后处理任务交给各自处理器,并由不同阶段的队列与并发池消费。上传与入队、处理器注册。文档解析、切分和索引后,有图片则分派图片处理任务,之后衔接后处理;没有图片也有直接进入后处理的路径。文档与后处理选项均设置
MaxRetry(3),即首次失败后最多再重试三次,并设置执行超时。任务选项。失败后一定会重试吗?
不会。
Asynq根据处理器返回值判断失败,不会自行理解数据库中的failed:- 可重试的解析或索引错误返回
error,交给框架安排重试;已有完成记录、失效尝试等则按具体条件跳过。 - 获取知识库失败的一条路径会把文档标成
failed后返回nil;没有配置可用解析器时,也有记录失败后返回空结果的路径。这些业务失败不会因为状态名是failed就自动触发框架重试。知识库读取失败、解析器未配置。
处理器错误经现有中间件耗尽重试时,中间件记录死信,并尽力将适用的文档状态更新为失败,避免页面一直等待;回调还检查任务所属尝试,避免旧失败覆盖新处理。租约过期的恢复器可以直接归档任务,不经过这层处理器中间件;状态回写本身也可能失败。因此排查时要同时检查队列记录、文档状态与具体阶段错误,必要时由后续状态巡检纠偏。最终失败回写。
怎样判断整份文档处理结束?
有需要等待的增强子任务时,后处理阶段登记子任务数,将文档置于
finalizing;没有这类子任务时则直接完成。子任务到达可结算的终态后释放计数。数据库在同一事务内递减pending_subtasks_count,并在计数归零且状态仍满足条件时推进文档状态。后处理登记、事务内归并。这里的归零表示规定的任务槽已经结算,部分最终失败也会释放槽;它不证明每一次可选的识别、摘要或增强调用都成功。检索可用性和可选增强结果需要分别观察。终态释放条件。
当前实现还有什么可靠性边界?
文件与文档记录保存后才入队,两者并不是一个数据库与 Redis 的原子事务。该版本入队失败时可以标记文档失败但仍返回
knowledge, nil,因为文件已经保存。因此调用方不能仅以 HTTP 成功判断任务已经开始。若要进一步完善,可以引入事务内待发送记录与补投扫描,并按业务键防重复;这是后续设计建议。此外,未配置
REDIS_ADDR时走 Lite 执行器。虽然名为SyncTaskExecutor,其Enqueue会启动进程内 goroutine,也有重试和最终失败回调,但没有 Redis 持久任务队列,不能承诺进程退出后任务仍会恢复。部署分支、Lite 执行器。- 可重试的解析或索引错误返回
图文检索和语义库如何构建?
展开收起
核心回答
WeKnora可以把文档图片转成可检索的文字,再关联回原图和来源段落。以图片描述与文字识别这条路线为例,图片处理结果分别写入image_caption、image_ocr子块,使用文本内容建立索引;子块通过ParentChunkID关联包含图片的文本块,并携带原图信息。命中子块后,系统补齐周围正文,组装带图片引用、识别文字与描述的上下文。图片处理可以按开关执行,也可以选用
smartocr:先观察图片属性并生成描述,再按属性策略决定是否调用OCR。因此,这条路线的关键是把图片变成可检索的语义文字,并保住图文关联,不依赖所有图片都进入共享图文向量空间。从图片到检索块
文档解析后,
ImageResolver.ResolveAndStore()将图片写入存储并替换正文中的图片地址。多模态阶段按图片创建后台任务;ImageMultimodalService读取原图,选择本次任务指定的处理流水线。图片提取与任务编排、单图处理。默认流水线按各自开关执行描述和
OCR;smartocr则通过一次观察调用取得属性和描述,再由DecideOCR()决定是否继续识别文字。观察失败时,默认采用保守策略继续OCR,这项回退也可配置。默认流水线、按需 OCR。有非空描述或识别文字时,处理器分别创建子块,将文字存入
Content,将图片地址等信息存入ImageInfo,并保留来源定位和ParentChunkID。在启用相应索引能力的知识库中,indexChunks()把这些文字内容交给Embedding模型和检索引擎,提供描述匹配与文字匹配入口。子块构建、文字索引。命中后怎样找回正确图文
合并阶段识别图片子块,先找到对应文本块;启用父子分块时,再补齐更大的
parent_text内容。同时保留命中的识别文字,并按命中文本范围和图片地址收窄图片信息,避免把同一大段中的其他图片内容混进来。图片子块的父块解析。例如检索产品手册中的“故障灯闪三次如何处理”:图片描述可提供故障灯与操作流程的语义,
OCR可提供图中的错误码和步骤文字;召回后需要保留这张图及其对应说明。验证时同时检查错误码是否识别正确、是否关联到正确图片、前提条件是否来自同一段说明。与直接图片向量的区别
该版本也支持单独开启图片向量:知识库启用
ImageVectorEnabled,且向量模型与调用协议支持图片输入时,才会创建image_vector子块并写入原图向量。这项能力默认关闭,是与图片描述索引并存的另一条检索通道。能力开关、原图向量索引。在普通问答流水线中,模型支持视觉输入时,系统会为图片向量命中的结果附加原图;仅命中描述不自动触发这项处理。对描述遗漏、数字读错等问题,应回查原图与图片处理结果,分别定位内容提取、召回和上下文关联的问题。原图附加条件。
父子检索如何工作,为什么在 RAG 中使用?
展开收起
核心回答
父子检索把用于匹配的小块与补充完整语义的父段分开。
WeKnora在入库时保存文本父子关系,检索服务按ParentChunkID补取上下文,聊天合并阶段再把命中结果展开为父正文;图片的OCR、描述子块也能沿关系找到正文和更大的父段。这样可以在命中具体文字或图意后,补回解释它所需的条件。父块按层次关联补取,邻块按文档顺序补取,关联块按已保存的关系补取,三者共同服务上下文组装。服务层返回结果和完整聊天链路还经过不同处理,不能把其中一处补取或过滤等同于最终交给模型的内容。
上下文扩展前,混合检索分别收集向量与关键词列表,通过可配置权重的
RRF按名次融合,并按ChunkID合并候选;两路结果都为空时返回空,存储检索出错时返回错误。只剩一路时走该路的去重和分数处理,不能当作两路仍在融合。后续父子补取负责扩展阅读上下文,不因此产生父段独立参与检索的相关性评分。候选融合入口、单路处理与加权 RRF、按块融合。入库时怎样建立父子关系?
开启
EnableParentChild后,文档先分成较大父块,再分成较小文本块。父块以parent_text类型保存到数据库,子块以text类型保存,通过ParentChunkID指向父块;进入文本检索索引的是子块,父块用于后续扩展。父子都保留原文范围和来源定位,便于回到原文。父子切分、父块保存和子块关联。图片还会产生另一层子块:非空识别文字保存为
image_ocr,描述保存为image_caption,它们的ParentChunkID指向所在的文本块,同时保存ImageInfo和SourceLocators。因此可能形成“图片子块 → 文本块 → 大父段”的两级关系。图片子块写入。命中后怎样补齐并避免重复?
processSearchResults()先批量读取原始命中块,并保存其分数、匹配类型和原始命中内容。未设置SkipContextEnrichment时,再由collectEnrichmentChunkIDs()收集三类 ID:- 当前块的
ParentChunkID。 RelationChunks中保存的关联块。- 有前后链接的
text块对应的PreChunkID、NextChunkID。
processedIDs同时记录原始命中与已经安排补取的 ID,避免多个命中重复拉取同一块。若原始结果包含图片子块,第一轮可以找到其文本父块,随后再用collectParentChunkIDs()补取文本块的大父段;第二轮只沿父关系继续,不重复扩展所有邻块和关联块。批量补取与图片第二轮、关联收集与去重。聊天链路怎样真正展开父正文?
聊天的
PluginMerge.OnEvent()会在选取检索或重排结果、初步去重后调用resolveParentChunks()。它直接按父 ID 批量读取块,不经过检索服务的结果类型过滤:text → parent_text:将大父段正文与命中子块内容合并到结果的Content,标记ContentRewritten,并保留子块标识。image_ocr、image_caption等图片命中:先找文本父块,有大父段时再向上一层读取,将父正文、文本正文和原识别内容合并。图片信息按命中的文本子块限定,父正文中的图片引用也据此清理,避免把同一大父段中其他位置的图片一并带入。
随后聊天层继续合并连续或重叠正文、补短上下文、做最终去重,并建立引用来源。例如用户问接线图中某个端子的含义,图片识别结果负责定位,父正文补充接线条件,原识别文字仍被保留,不会因替换成父正文而丢失。聊天合并顺序、父关系批量解析、文本与图片展开。
补充块的分数和顺序怎样理解?
在检索服务的补取记录中,新补取的父块沿用触发它的子块分数,并标记为
MatchTypeParentChunk;关联块和邻块若没有分数,组装时使用0。这个父块分数是关联传递的记录,不是父段独立参与原始检索得到的相关性分数。 多个子块指向同一父块,也不是在这里重新计算父段的相关性。聊天层展开正文同样不会因此产生一次新的父段相关性评分。检索服务组装结果时,原始命中按输入顺序加入,补充块随后追加;这里没有对所有新增上下文做一次统一重排。显式重排入口则先对未扩展的候选进行重排,再补上下文并保留原始命中项的重排结果,扩展本身仍是另一阶段。分数传递、结果组装、重排后扩展。
当前实现有哪些取舍与缺口?
共享检索服务有一个需要注意的边界:
processSearchResults()补取大父块后,组装调用的isSearchableChunk()没有允许parent_text,所以该父块不会作为独立结果返回。聊天链路仍能通过上述resolveParentChunks()直接取父块并展开正文,不能据此说整个项目无法返回父上下文。 如果调用方只消费共享检索接口,就要单独验证父段是否已进入返回内容;完善该接口时,应区分可直接检索的块与可用于上下文扩展的块。大父块类型、组装阶段的类型过滤、允许类型。扩展还会增加数据库读取和上下文长度。使用时应比较关闭扩展、仅补父关系、补父关系加邻块等方案,在相同文档与问题集上观察证据完整性、重复内容、上下文用量和回答条件是否正确。服务层的
processedIDs只按块 ID 去重,聊天层还另做内容签名和部分重叠去重;即使去重完成,也不能把“大量补回正文”直接当成准确率提升。参考资料
- 国内:腾讯云智能体开发平台:文档切分设置:采用先切父片段、再切子片段,以及子片段用于匹配、父片段用于生成上下文的解释;具体 WeKnora 行为按上述源码展开。
- 国内:JavaGuide:RAG文档处理与切分:采用检索粒度和阅读上下文分开设计的思路,解释小块匹配与父段补全的用途。
- 国内:zero2Agent:RAG与检索:采用子块记录父标识、回取后去重的组织方式,解释重复命中同一父段为何需要合并处理。
- 国内:WeThinkIn:父子检索与相邻块扩展:采用结构关系、线性邻接和上下文预算的区分,说明补充证据不等于新的高相关命中。
- 国外:LangChain:Docugami Small-to-Big 检索:采用子块向量索引、父对象存储和父标识关联的职责划分,解释两类内容可以分别存取。
- 国外:LlamaIndex:Auto Merging Retriever:参考按叶节点命中比例递归合并父节点的变体,说明父子检索并非只有一种返回策略;WeKnora 这里采用显式关联补取。
- 当前块的